 Python
 PostgreSQL
Sobre el proyecto
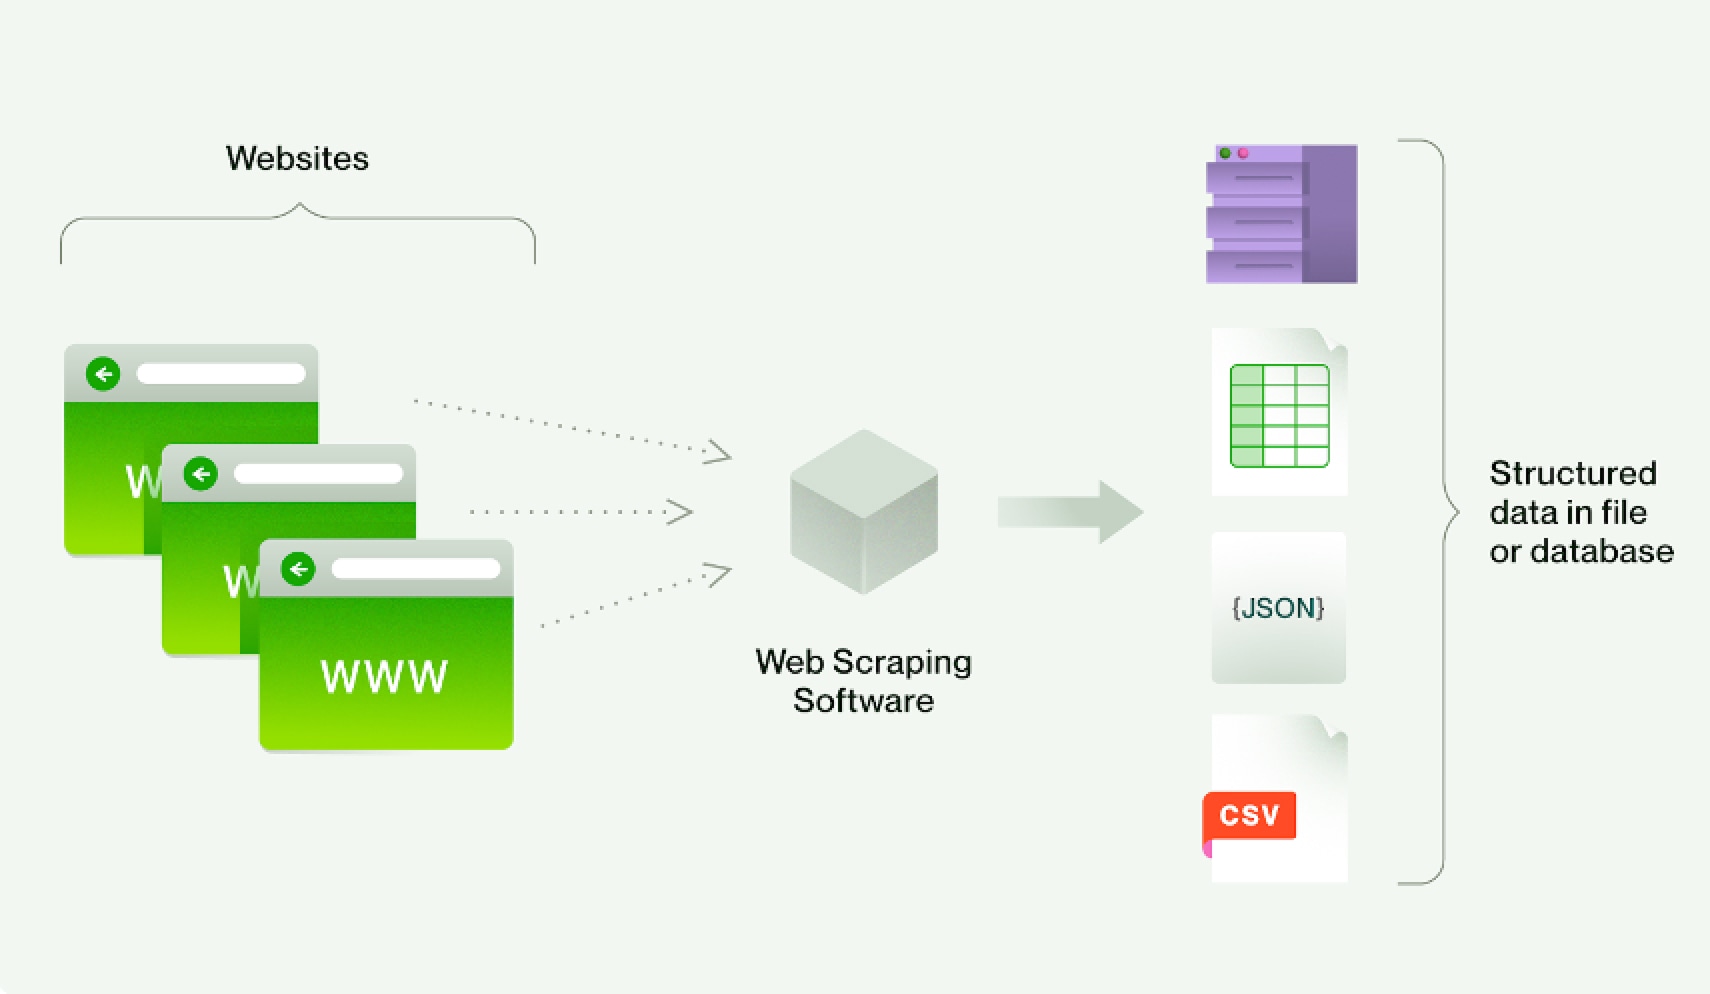
Pipeline de web scraping asistido por IA: recorre sitios web usando sitemaps y técnicas de scraping (BeautifulSoup para HTML estático, Playwright para páginas dinámicas), envía el contenido extraído a un LLM para normalizar y estructurar la información, y almacena los resultados en PostgreSQL. Diseñado para ser genérico y reutilizable en diferentes dominios de datos.
Desarrollamos un pipeline en Python que combina scraping (BeautifulSoup, httpx, Playwright), descubrimiento vía sitemaps, procesamiento con OpenAI para extraer y estructurar datos, y persistencia en PostgreSQL. Dockerizado para despliegue reproducible.
AI-Powered Web Scraping
Funcionalidades clave
¿Dónde buscar?
Los sitemaps guían al pipeline: encuentra todas las páginas relevantes sin explorar a ciegas ni depender de enlaces manuales.
¿Cómo extraer?
HTML estático o páginas que cargan con JavaScript: el scraper elige la estrategia correcta para cada sitio.
¿Y el ruido?
La IA interpreta el contenido en bruto, extrae lo que importa y lo transforma en datos coherentes, sin reglas fijas por sitio.
¿Dónde queda todo?
Una base relacional lista para consultas, reportes o integraciones con otros sistemas de la empresa.
¿Cómo se ejecuta?
En un contenedor que corre igual en tu máquina, un servidor o un cron job: despliegue predecible.
¿Para qué sirve?
Competidores, precios, contenido o inventarios: el mismo pipeline se adapta al dominio que necesites.